Being-M0.7 laat G1 speelgoed pakken met hulp van een spiegel
Het model leert van menselijke bewegingen én robotdata. In drie kleine laboratoriumproeven loopt G1 naar voorwerpen toe en probeert hij ze te pakken.
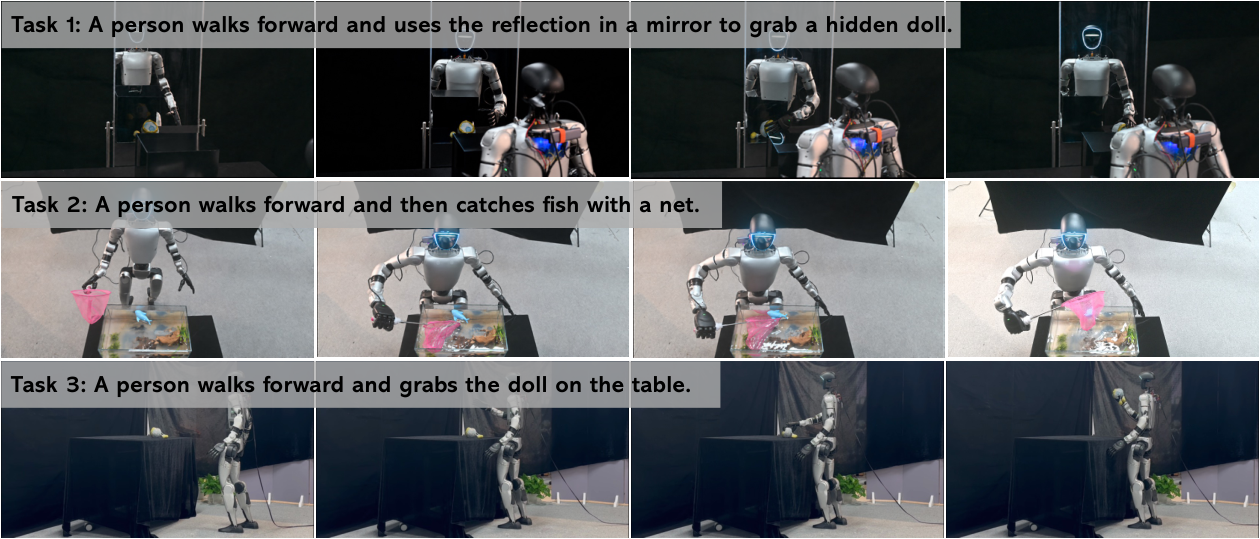
Het BeingBeyond-team beschrijft Being-M0.7 in een preprint van 8 oktober. Het model wordt eerst getraind op menselijke opnamen en daarna aangepast met robotdata. Een fysieke G1 voert drie taken uit: een speelgoedvis met een net uit water halen, een verborgen pop via een spiegel vinden en pakken, en naar een pop toe lopen om die te pakken. De opstelling gebruikt LinkerHand O6-handen, een RealSense D435i-camera en een externe computer met RTX 4090. Elke taak krijgt vijf pogingen van maximaal dertig seconden. Dertien van de vijftien slagen, evenveel als het vergeleken GR00T N1.6-model. Robot en tafel starten op vaste plekken. Dit zijn beperkte laboratoriumtaken; langere reeksen en betrouwbare uitvoering in wisselende omgevingen zijn nog niet aangetoond.
Wat betekent dit?
Menselijke opnamen kunnen robottraining aanvullen. Juist de vaste opstelling en het kleine aantal pogingen maken duidelijk waarom zo'n proef nog gevolgd moet worden door bredere tests op een echte werkplek.
Bron: BeingBeyond Team ↗. Samengevat door YourWally op basis van de publicatie van de onderzoekers.