EquivDP3 onderzoekt hoe een G1 met minder voorbeelden leert
KAIST-onderzoekers testen een andere verwerking van 3D-beelden. Bij weinig voorbeelden werkt die gemiddeld beter, maar alle proeven vinden plaats in simulatie.
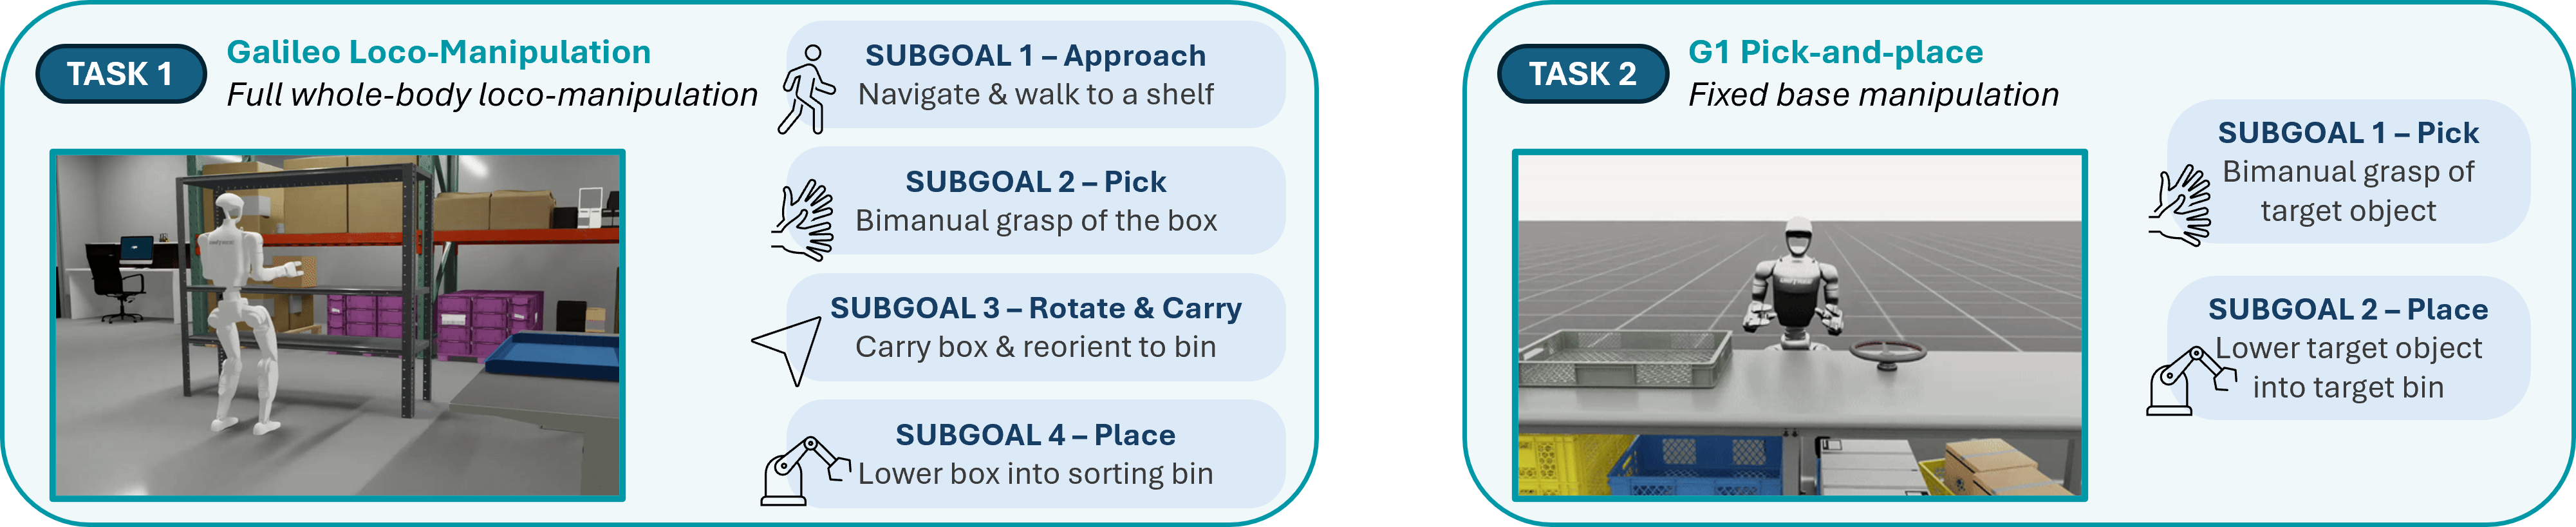
Onderzoekers van KAIST beschrijven in een preprint van 29 september EquivDP3. Hun software verwerkt 3D-puntenwolken zo dat draaien, verplaatsen en schalen minder invloed hebben op wat de robot herkent. Ze testen twee taken met een gesimuleerde Unitree G1: lopend een doos ophalen en verplaatsen, en voorwerpen oppakken vanaf een vaste positie. Bij vijf tot tien demonstraties haalt de methode gemiddeld 67,1 procent geslaagde pogingen, tegenover 38,2 tot 52,4 procent bij de vergelijkingsmethoden. Bij meer voorbeelden verdwijnt het voordeel. Per configuratie is slechts één trainingsronde uitgevoerd; een fysieke G1 is niet getest.
Wat betekent dit?
Minder voorbeelden kunnen het aanleren van nieuwe taken goedkoper maken. Dit is een eerste onderzoeksaanwijzing. Herhaalde trainingen en proeven met echte camera’s, handen en voorwerpen moeten nog laten zien of de aanpak praktisch bruikbaar is.
Bron: Abu Hanif Muhammad Syarubany en Chang D. Yoo (KAIST), EquivDP3 ↗. Samengevat door YourWally op basis van de publicatie van de onderzoekers.